ディープラーニングの学習と推論のほとんどは、浮動小数点数(小数点を含む数値)の演算で行われます。
これは、ディープラーニングが本質的に連続的な勾配ベースの最適化に依存しているためです。
浮動小数点演算が必須である理由
1. 勾配の計算と伝播 (Gradient Calculation and Propagation)
ディープラーニングモデルの学習(トレーニング)は、勾配降下法(Gradient Descent)に基づいており、モデルの重みを調整するために以下の計算が不可欠です。
微分(勾配): 損失関数を重みで微分することで勾配を求めますが、この微分値は通常、0に近い非常に小さな実数(小数点以下の値)になります。
誤差逆伝播 (Backpropagation): 勾配はこの小さな値としてネットワークの層を遡って伝播していきます。もし整数演算のみを使用すると、これらの重要な小さな変化(勾配)が丸められて失われ、学習が適切に進まなくなります。
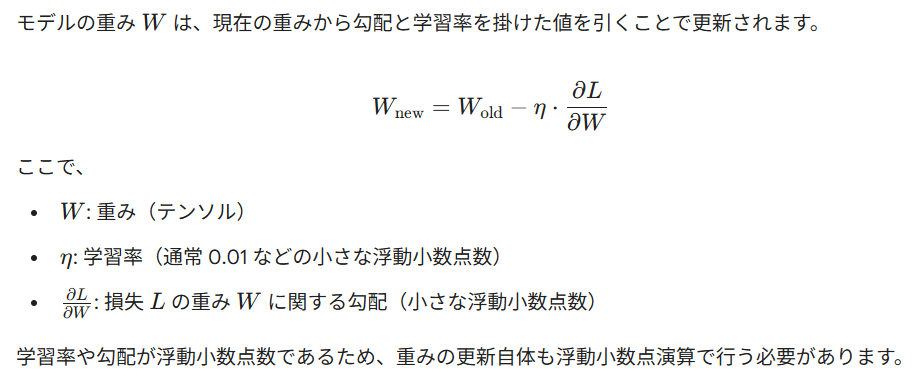
2. 重みの更新 (Weight Update)
3. 活性化関数の出力 (Activation Function Output)
ニューラルネットワークの各層の出力は、活性化関数(例:ReLU、Sigmoid、Softmaxなど)を通過します。
特にSigmoidやSoftmax関数は、出力を 0 から 1 の範囲の確率的な値(浮動小数点数)として返します。これらの値が次の層への入力となるため、ネットワーク全体を通して浮動小数点演算が維持されます。
GPUとデータ型 (Datatypes)
この大量の浮動小数点演算を効率的に行うために、GPUの並列計算能力が活用されます。
ディープラーニングでは、主に以下の浮動小数点データ型が使われます。
FP32 (単精度浮動小数点数): 標準的な学習と推論に使われるデータ型です。
FP16 (半精度浮動小数点数) や BF16: 最近のGPUでは、メモリ使用量を減らし、計算速度をさらに向上させるために、精度の低いこれらのデータ型(特に混合精度トレーニングという手法)も広く利用されています。
このように、浮動小数点数はディープラーニングにおける連続的な最適化プロセスを表現する上で不可欠な要素であり、GPUはその計算を担う中核的な役割を果たしています。
光ニューラルネットワークが光回路を使ってどのように高速情報処理を行うかについて、さらに詳細を知ることができます。(PyTorchによる畳み込み演算)
ありがとうございます。
PR:
 | SDS8000Aシリーズ オシロスコープ 特長と利点 |
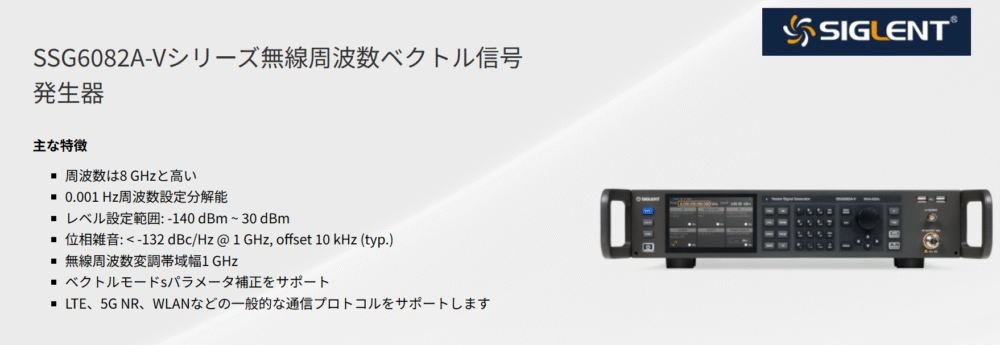
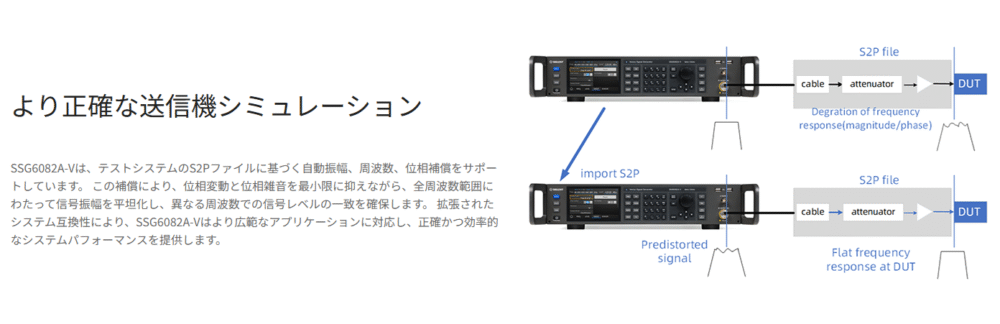
 | SSG6M80Aシリーズ |
 |  |
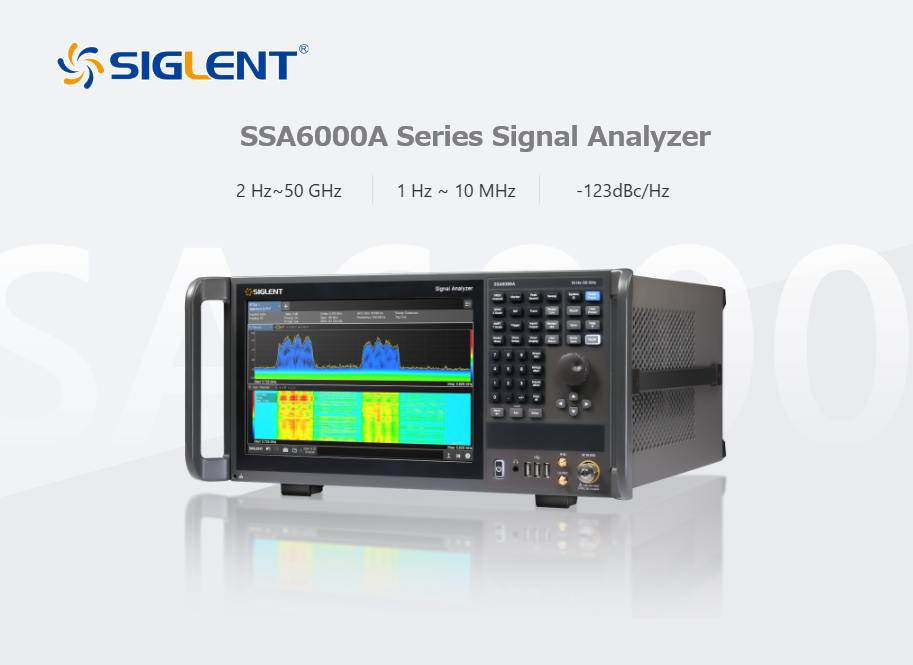 | SSA6000A Series Signal Analyzer Main Features |
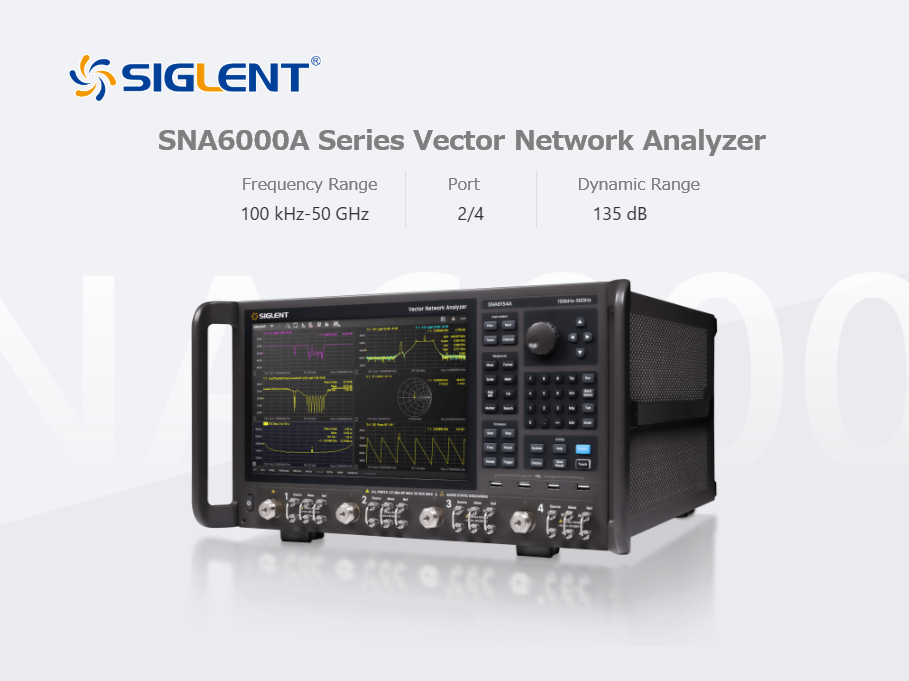 | SNA6000A Series Vector Network Analyzer Key Features |
お礼、
T&Mコーポレーションは設立5年ですが、おかげさまで業績を着実に伸ばしており、
オフィスを港区芝(最寄り駅浜松町)に移転し、スペースも拡大いたしました。
電子計測器業界の「ゲームチェンジャー」として、高性能/高信頼/低価格/短納期を武器に
T&Mコーポレーションはお客様のご予算を最大限生かす製品群をご提案させていただいております。