安謀科技(Arm China、中国名:安谋科技)が発表した「周易(Zhou Yi)」X3 NPU IPは、特に端側AIGC(AI Generated Content、AI生成コンテンツ)の処理能力を大幅に向上させることに焦点を当てたAIプロセッサの設計資産(IP)です。
この「周易」X3 NPU IPの最大の特徴は、前世代と比較して端側AIGC性能を最大10倍に向上させた点にあります。これは、モバイル端末やIoTデバイスなどのエッジデバイス上で、より高度な生成AIアプリケーションをリアルタイムで実行可能にすることを目指しています。
「周易」X3 NPU IPの主なポイント
特徴 | 詳細 | 意味合い |
ターゲット | 端側AIGC (On-device AIGC) | デバイス本体(スマートフォン、車載システムなど)でAIモデルを動かし、リアルタイムな画像生成や文章作成を行う。 |
性能向上 | AIGC性能 最大10倍 | 従来のNPUと比較して、特に大規模な生成AIモデル(Stable DiffusionやLLMなど)の推論速度が劇的に向上。 |
技術的焦点 | 生成AIモデルへの最適化 | 大規模なTransformerモデルの処理に必要な計算効率やメモリ帯域幅を強化。 |
役割 | NPU IP (Neural Processing Unit Intellectual Property) | Arm Chinaが開発したAI演算専用回路の設計図。半導体メーカーはこれを導入し、自社のチップ(SoC)に組み込みます。 |
性能向上の背景と技術的意義
この10倍という性能向上は、主に以下の技術的ブレークスルーによって実現されていると推測されます。
トランスフォーマー演算の効率化:
生成AIの基盤であるTransformer(トランスフォーマー)モデルの計算パターン(特に行列乗算)に特化した演算器の最適化。
キー・バリューキャッシュ (KV Cache) の効率的な管理など、推論時のメモリアクセスを最適化し、遅延を最小限に抑える技術。
高性能なデータ型サポート:
AIGCモデルの推論で一般的に使用される低精度なデータ型(例:INT8や混合精度)の演算効率を極限まで高め、電力効率を維持しながらスループットを向上させています。
スケーラビリティの向上:
チップメーカーのニーズに応じて、NPUコア数やメモリ帯域幅を柔軟に構成できる高いスケーラビリティを備え、低消費電力なモバイルチップから高性能なサーバーチップまで、幅広い製品に対応可能にしていると考えられます。
この技術は、中国のAIチップ開発エコシステムにおいて、Arm Chinaが提供するIPコアをベースにした端側AIの競争力を高める重要な一歩となります。
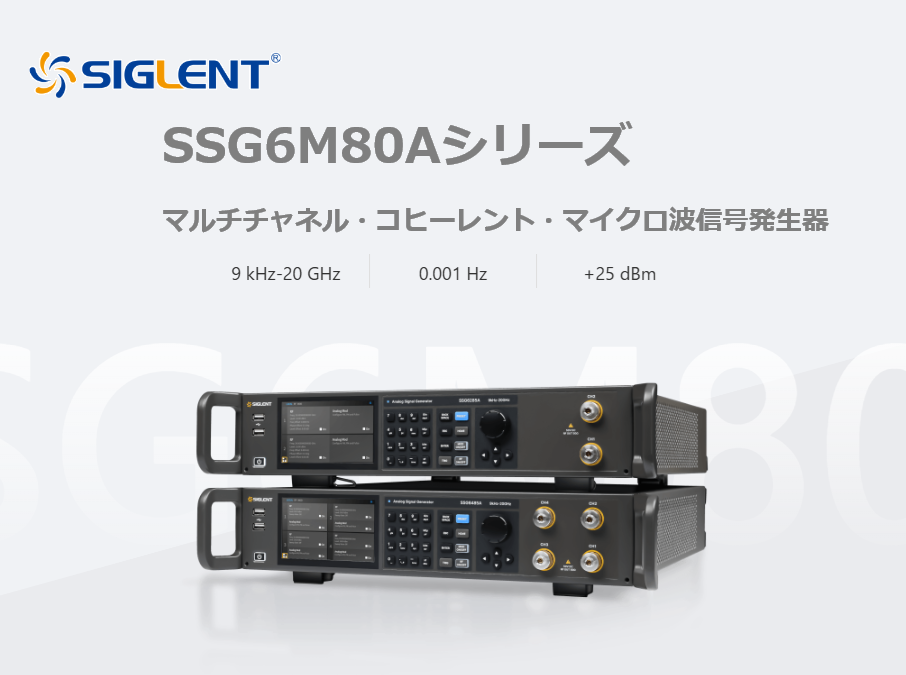 | SSG6M80Aシリーズ |
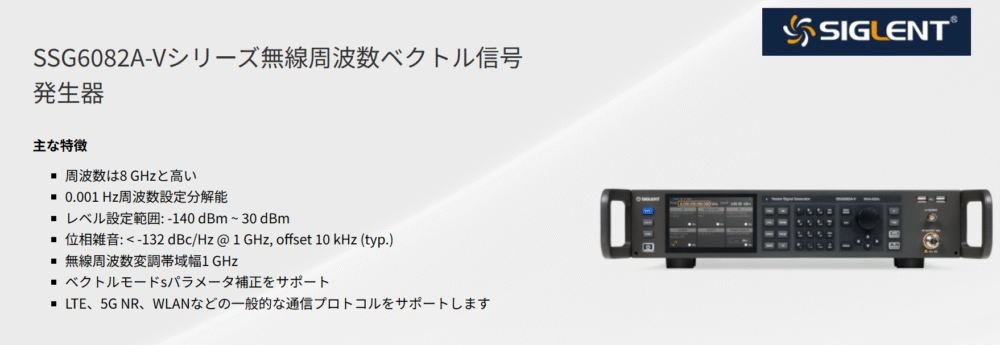 | 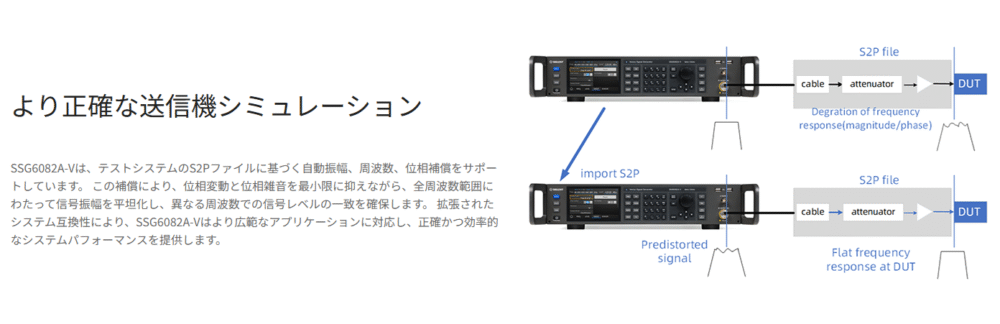 |
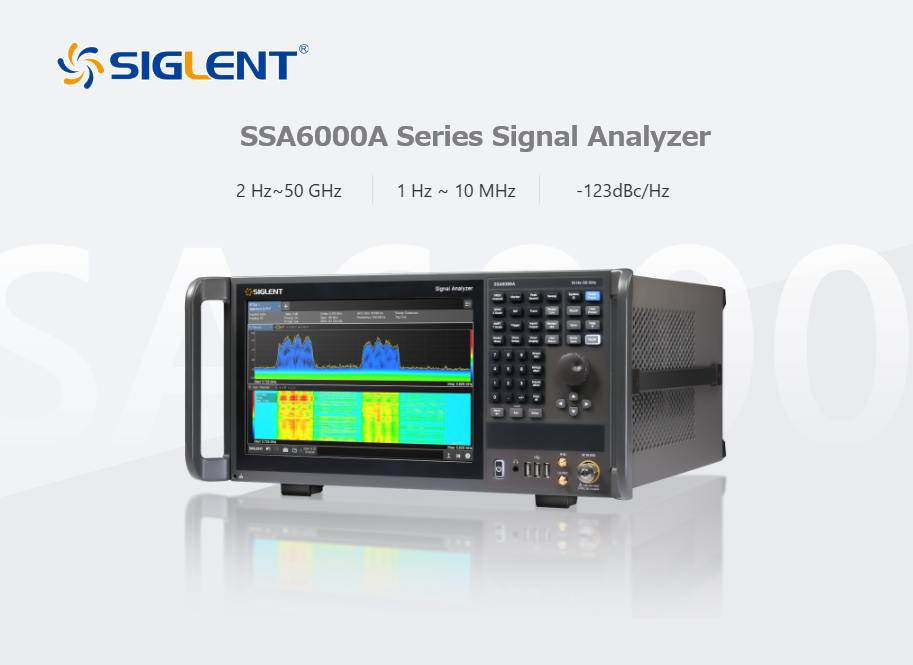 | SSA6000A Series Signal Analyzer Main Features |
 | SNA6000A Series Vector Network Analyzer Key Features |